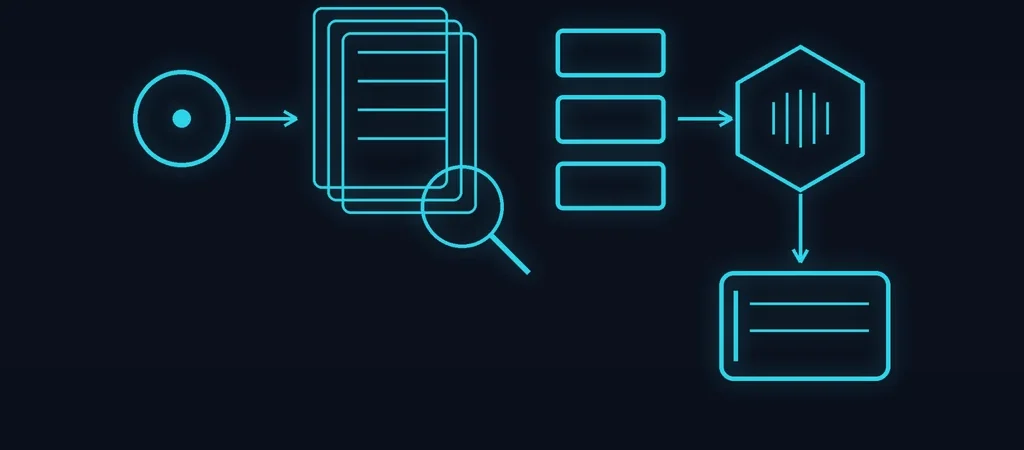
RAG son las siglas en inglés de generación aumentada por recuperación. Es la técnica que conecta un modelo de lenguaje con tus documentos: antes de responder, el sistema busca los fragmentos relevantes y los pone delante del modelo. El modelo redacta con ese material a la vista. Entender qué es RAG importa porque resuelve el problema central de cualquier asistente de empresa. Un modelo solo sabe lo que vio al entrenarse, así que no conoce tus precios ni tus políticas, y puede inventarlos con tono seguro. Con RAG responde desde tu propia fuente, y además puede citar de qué documento salió cada dato. Aquí verás cómo funciona paso a paso, en qué se diferencia del ajuste fino, qué necesitas para montarlo cómo medir si responde bien y los cinco errores que hacen que un asistente conteste mal.
¿Qué es RAG?
RAG son las siglas en inglés de generación aumentada por recuperación. Es una técnica que conecta un modelo de lenguaje con tus documentos: antes de responder, el sistema busca los fragmentos relevantes y se los entrega al modelo. El modelo redacta la respuesta con ese material a la vista.
El problema que resuelve es concreto. Un modelo de lenguaje solo sabe lo que vio durante su entrenamiento, así que no conoce tus precios, tus políticas ni tu catálogo. Si le preguntas, puede inventar una respuesta con tono seguro. RAG evita eso porque le pone delante la fuente correcta antes de que escriba.
La idea viene de un trabajo de investigación de 2020 que propuso combinar recuperación de documentos con generación de texto. Puedes leer el artículo original que introdujo RAG si te interesa el detalle técnico. Hoy es el enfoque estándar para cualquier asistente que deba responder sobre información propia de una empresa.
¿Cómo funciona un sistema RAG, paso a paso?
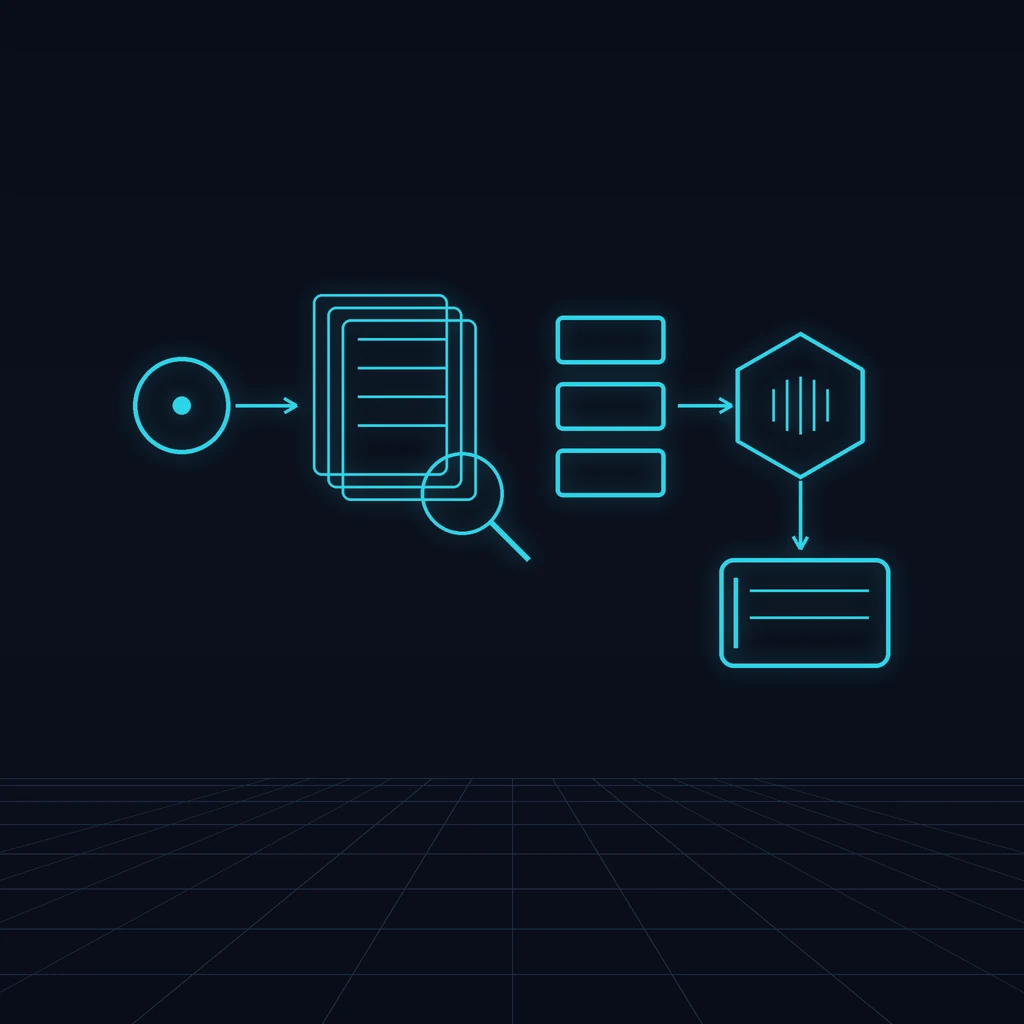
Todo RAG tiene dos momentos: uno de preparación, que ocurre una vez, y otro de consulta, que ocurre en cada pregunta.
En la preparación se carga el conocimiento. Primero se reúnen los documentos: precios, políticas, manuales, preguntas frecuentes. Luego se cortan en fragmentos de tamaño manejable. Después cada fragmento se convierte en un vector, que es una representación numérica de su significado. Finalmente esos vectores se guardan en una base de datos preparada para buscar por parecido.
En la consulta ocurre lo interesante. La pregunta del usuario también se convierte en vector. El sistema busca los fragmentos más parecidos y selecciona los mejores. Esos fragmentos se añaden a la instrucción que recibe el modelo, junto con una orden clara: responde solo con esto. Así el modelo redacta con tu información, no con su memoria.
Ese último detalle es lo que diferencia un RAG bien montado de uno descuidado. Si no le prohíbes salirse de la fuente, el modelo completa los huecos por su cuenta. Las consecuencias de eso las explicamos en alucinaciones de la IA.
RAG o ajuste fino: cuál conviene
La otra forma de darle conocimiento a un modelo es el ajuste fino, es decir, reentrenarlo con tus datos. Son enfoques distintos y resuelven problemas distintos:
| Criterio | RAG | Ajuste fino |
|---|---|---|
| Qué le enseña | Información concreta | Estilo y formato de respuesta |
| Actualizar un dato | Se cambia el documento | Hay que reentrenar |
| Costo de arranque | Bajo | Alto |
| Puede citar la fuente | Sí | No |
| Riesgo de inventar | Bajo si se limita bien | Se mantiene |
| Cuándo elegirlo | Datos que cambian | Tono muy específico |
Para un negocio la elección casi siempre es RAG, porque los precios y las políticas cambian y nadie quiere reentrenar un modelo cada vez que sube una tarifa. El ajuste fino tiene sentido cuando el problema es cómo suena la respuesta, no qué dice. De hecho, los dos se pueden combinar.
¿Qué necesitas para montar RAG en tu empresa?
Menos infraestructura de lo que parece y más orden del que la gente espera. Hacen falta cuatro cosas:
- Documentación escrita y vigente. Si tus precios solo viven en la cabeza del dueño, no hay nada que recuperar.
- Una sola versión de cada documento. Dos listas de precios distintas garantizan respuestas contradictorias.
- Un responsable del contenido. Alguien que actualice la fuente cuando algo cambie.
- Un criterio de qué no se responde. Lo que debe pasar a una persona, aunque el sistema tenga el dato.
El primer punto es el que detiene más proyectos. RAG no crea conocimiento, lo organiza y lo pone a mano. Por eso la parte más larga de estos proyectos no es técnica: es reunir y depurar lo que la empresa nunca escribió.
¿Cómo se mide si un RAG responde bien?
Aquí está la diferencia entre un asistente que parece funcionar y uno que funciona. Un sistema RAG se evalúa en dos partes separadas, porque los fallos vienen de sitios distintos.
La primera parte es la recuperación. ¿Trajo el fragmento correcto? Se mide tomando preguntas reales y revisando a mano si el documento recuperado contenía la respuesta. Cuando falla aquí, el problema está en cómo cortaste los documentos o en la calidad de la fuente.
La segunda parte es la redacción. Dado el fragmento correcto, ¿la respuesta fue fiel? Se revisa si el modelo añadió algo que no estaba en la fuente. Cuando falla aquí, el problema está en las instrucciones, no en los documentos.
Separar las dos mediciones ahorra semanas, porque indica dónde corregir. Lo práctico es armar un banco de cincuenta preguntas reales de tus clientes y revisarlas cada vez que cambies algo del RAG. Así cualquier ajuste se compara contra la misma vara.
Errores que arruinan un proyecto RAG
Cuando un asistente con RAG responde mal, casi siempre es por una de estas razones:
- Fragmentos demasiado grandes o pequeños. Muy grandes diluyen la respuesta; muy pequeños pierden el contexto.
- Documentos obsoletos sin retirar. El sistema recupera la tarifa del año pasado porque sigue ahí.
- No exigir cita de la fuente. Sin eso no puedes auditar de dónde salió una respuesta.
- Mezclar temas en una sola base. Conviene separar por dominio, porque si no la búsqueda trae lo parecido pero inútil.
- No medir las respuestas. Sin revisar casos reales no sabes qué preguntas falla.
En Aigenza montamos los agentes sobre esta arquitectura y empezamos por un conjunto acotado de documentos, no por todo el archivo. Así se puede verificar respuesta por respuesta antes de abrir el canal. Puedes ver el servicio en chatbot con inteligencia artificial.
En resumen, RAG es lo que convierte un modelo genérico en un asistente que habla de tu negocio con datos verificables. Sin documentación ordenada, en cambio, no hay técnica que lo salve.
Preguntas frecuentes
¿RAG elimina las respuestas inventadas?
Las reduce mucho, aunque no las elimina solo por existir. Hay que limitar el modelo a la fuente recuperada y pedirle que admita cuando no encuentra el dato.
¿Mis documentos quedan expuestos?
Depende de la arquitectura que elijas, porque los fragmentos viajan al modelo en cada consulta. Por eso conviene definir desde el inicio qué documentos entran y qué proveedor los procesa.
¿Sirve RAG con PDF y hojas de cálculo?
Sí, aunque los formatos no se comportan igual. Un PDF de texto se procesa bien, mientras que una hoja de cálculo con cifras suele rendir más si se consulta directo en lugar de recuperarla por parecido.
¿Cada cuánto hay que actualizar la base?
Cuando cambie el contenido, no en un calendario fijo. Lo práctico es conectar la fuente original para que el cambio entre solo, de modo que nadie dependa de recordar hacerlo.
¿Quieres un asistente que responda con tus precios y políticas, no con inventos?
Ver chatbot con IA